

Velvet2-3B Speech
29 de octubre de 2026
Un modelo multilingüe para el análisis del habla, diseñado para comprender el contenido oral más allá de las palabras y captar la información transmitida a través del habla, con el fin de realizar tareas lingüísticas complejas directamente a partir del audio.
La Esencia de Velvet2-3B Speech
Velvet2-3B-Speech se basa en el foundation model de lenguaje Velvet2 e integra el procesamiento del habla, creando un modelo versátil para aplicaciones en las que la voz constituye una fuente natural de información.
Idiomas
Inglés, italiano, español, portugués, francés y alemán.
Arquitectura
Modelo de lenguaje Velvet2-3B, codificador de audio Whisper Large v3 y un proyector específico.
Training Dataset
Casi 30 millones de ejemplos de audio en seis idiomas, con un total aproximado de 95.000 horas de habla.
Context Window
32K tokens. Procesa hasta 22 minutos de audio.
IA Responsable
Las medidas de seguridad abarcan la selección de datos, el entrenamiento, el postentrenamiento, la evaluación y la gobernanza.
Parámetros
Modelo de lenguaje de 3B, más un codificador de audio de 0,7B.
Data Freshness
Fecha límite de los datos de preentrenamiento: diciembre de 2025 – enero de 2026.
Licencia
Open-weight con licencia Apache 2.0.
Capacidades
Automatic Speech Recognition
Extracción de información
Traducción del habla
Reconocimiento de emociones en el habla
Function
Calling a partir del habla
Identificación del idioma
Seguimiento de instrucciones
Respuesta a preguntas a partir del habla
Conversaciones multiturno
Generación de resultados estructurados
Resumen a partir del habla
Performance Evaluation
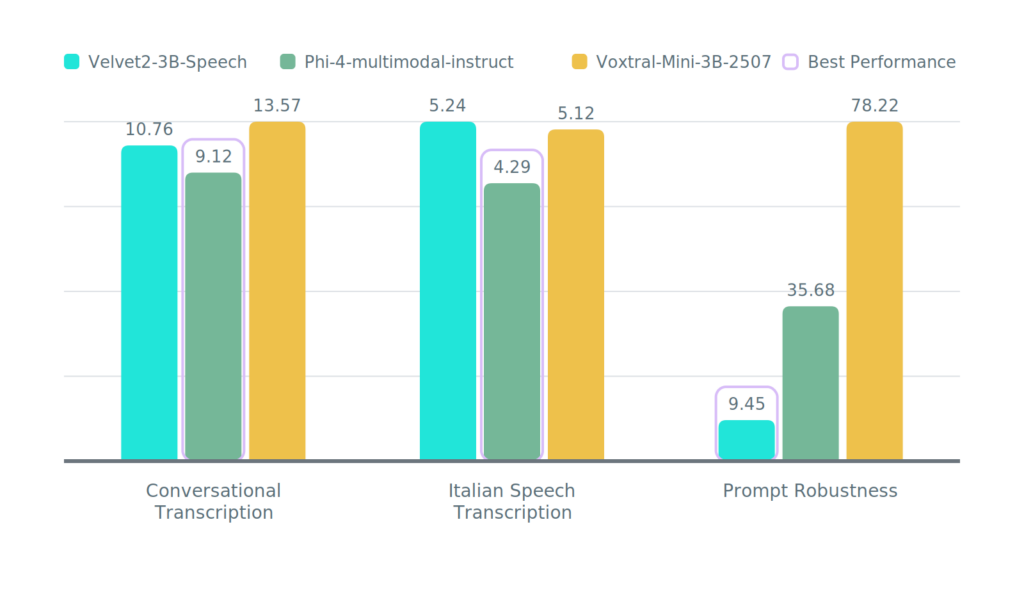
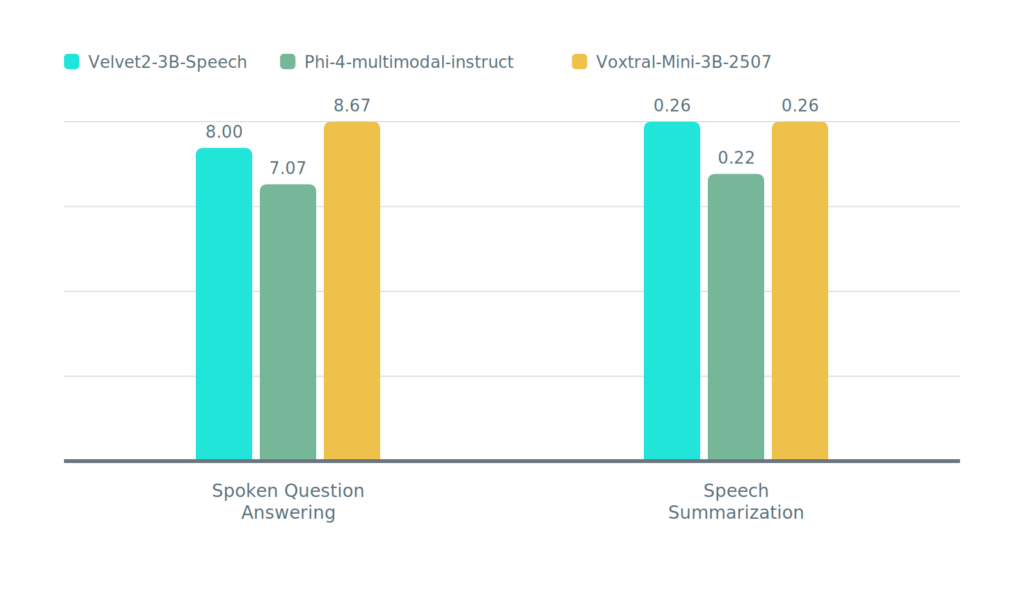
Velvet2-3B-Speech se evaluó mediante una serie de benchmarks que abarcan el reconocimiento del habla, la comprensión del lenguaje hablado, la traducción y el reconocimiento de emociones.
Transcription & Robustness
Speech Understanding
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Métricas
Transcripción de conversaciones (AMI)
Mide la precisión de la transcripción de conversaciones y reuniones reales.
Ejemplo de prompt: “Transcribe esta conversación con precisión.”
Transcripción del habla en italiano (Multilingual ASR Italian)
Mide la precisión de la transcripción del italiano hablado.
Ejemplo de prompt: “Transcribe este audio en italiano.”
Robustez frente a los prompts (DOWIS)
Mide la coherencia de la transcripción con instrucciones formuladas de distintas maneras.
Ejemplo de prompt: “Transcribe exactamente lo que se está diciendo.”
Respuesta a preguntas orales (HeySquad EN)
Mide la capacidad de comprender y responder preguntas formuladas oralmente.
Ejemplo de prompt: “Escucha la pregunta y dame la respuesta.”
Resumen del habla (VoxPopuli-L EN)
Mide la capacidad de resumir contenidos orales extensos.
Ejemplo de prompt: “Resume los puntos principales de esta grabación.”
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-14B
Velvet-25B
¿Por Qué Velvet2-3B Speech?
Contenidos de audio y multimedia
Turn spoken content into information that can be analyzed, summarized and queried, while capturing additional signals such as emotion to support richer processing of large audio and multimedia collections.
Contenidos de voz multilingües
Permite interacciones de voz en entornos multilingües, incluidas conversaciones en las que los hablantes cambian de idioma.
Tareas lingüísticas a partir del habla
Utiliza la voz como punto de partida para responder preguntas, resumir y activar funciones, en lugar de limitarse a la transcripción.