

Velvet2-3B Text
29 de octubre de 2026
Un modelo de lenguaje compacto, sometido a un amplio postentrenamiento para comprender instrucciones complejas, abordar tareas de razonamiento y generar resultados estructurados, equilibrando rendimiento, tiempos de respuesta y requisitos computacionales.
La Esencia de Velvet2-3B
Diseñado para aplicaciones reales, Velvet2-3B combina un amplio postentrenamiento con una arquitectura compacta, ofreciendo una base versátil para una amplia gama de tareas lingüísticas.
Idiomas
Italiano, inglés, alemán, español, francés y portugués.
Arquitectura
Dense autoregressive decoder-only Transformer con 38 capas Transformer.
Training Dataset
Aproximadamente 5 billones de tokens procedentes de fuentes públicas, seleccionados según criterios de calidad, seguridad, deduplicación y equilibrio multilingüe.
Context Window
32K tokens, ampliables mediante YaRN.
Parámetros
3.000 millones de parámetros.
Vocabulario
127K tokens.
Specialization
3,5 millones de ejemplos de instrucciones anotados por personas y sintéticos.
Data Freshness
Training Infrastructure
Entrenado en el superordenador italiano Leonardo, alojado en CINECA.
Licencia
Open-weight con licencia Apache 2.0.
IA Responsable
Capacidades
Seguimiento de instrucciones
Extracción de información
Comprensión de contextos extensos
Generación de resultados estructurados
Function
Calling
Generación sujeta a JSON y esquemas
Comprensión de tablas y datos semiestructurados
Generación de texto multilingüe
Tareas Chain-of-Thought
Conversaciones multiturno
Generalización Few-Shot
Resumen
Question Answering
RAG
Performance Evaluation
Velvet2-3B se evaluó mediante una amplia variedad de benchmarks que abarcan conocimiento, seguimiento de instrucciones, razonamiento, comprensión de contextos extensos, function calling, capacidades multilingües y seguridad.
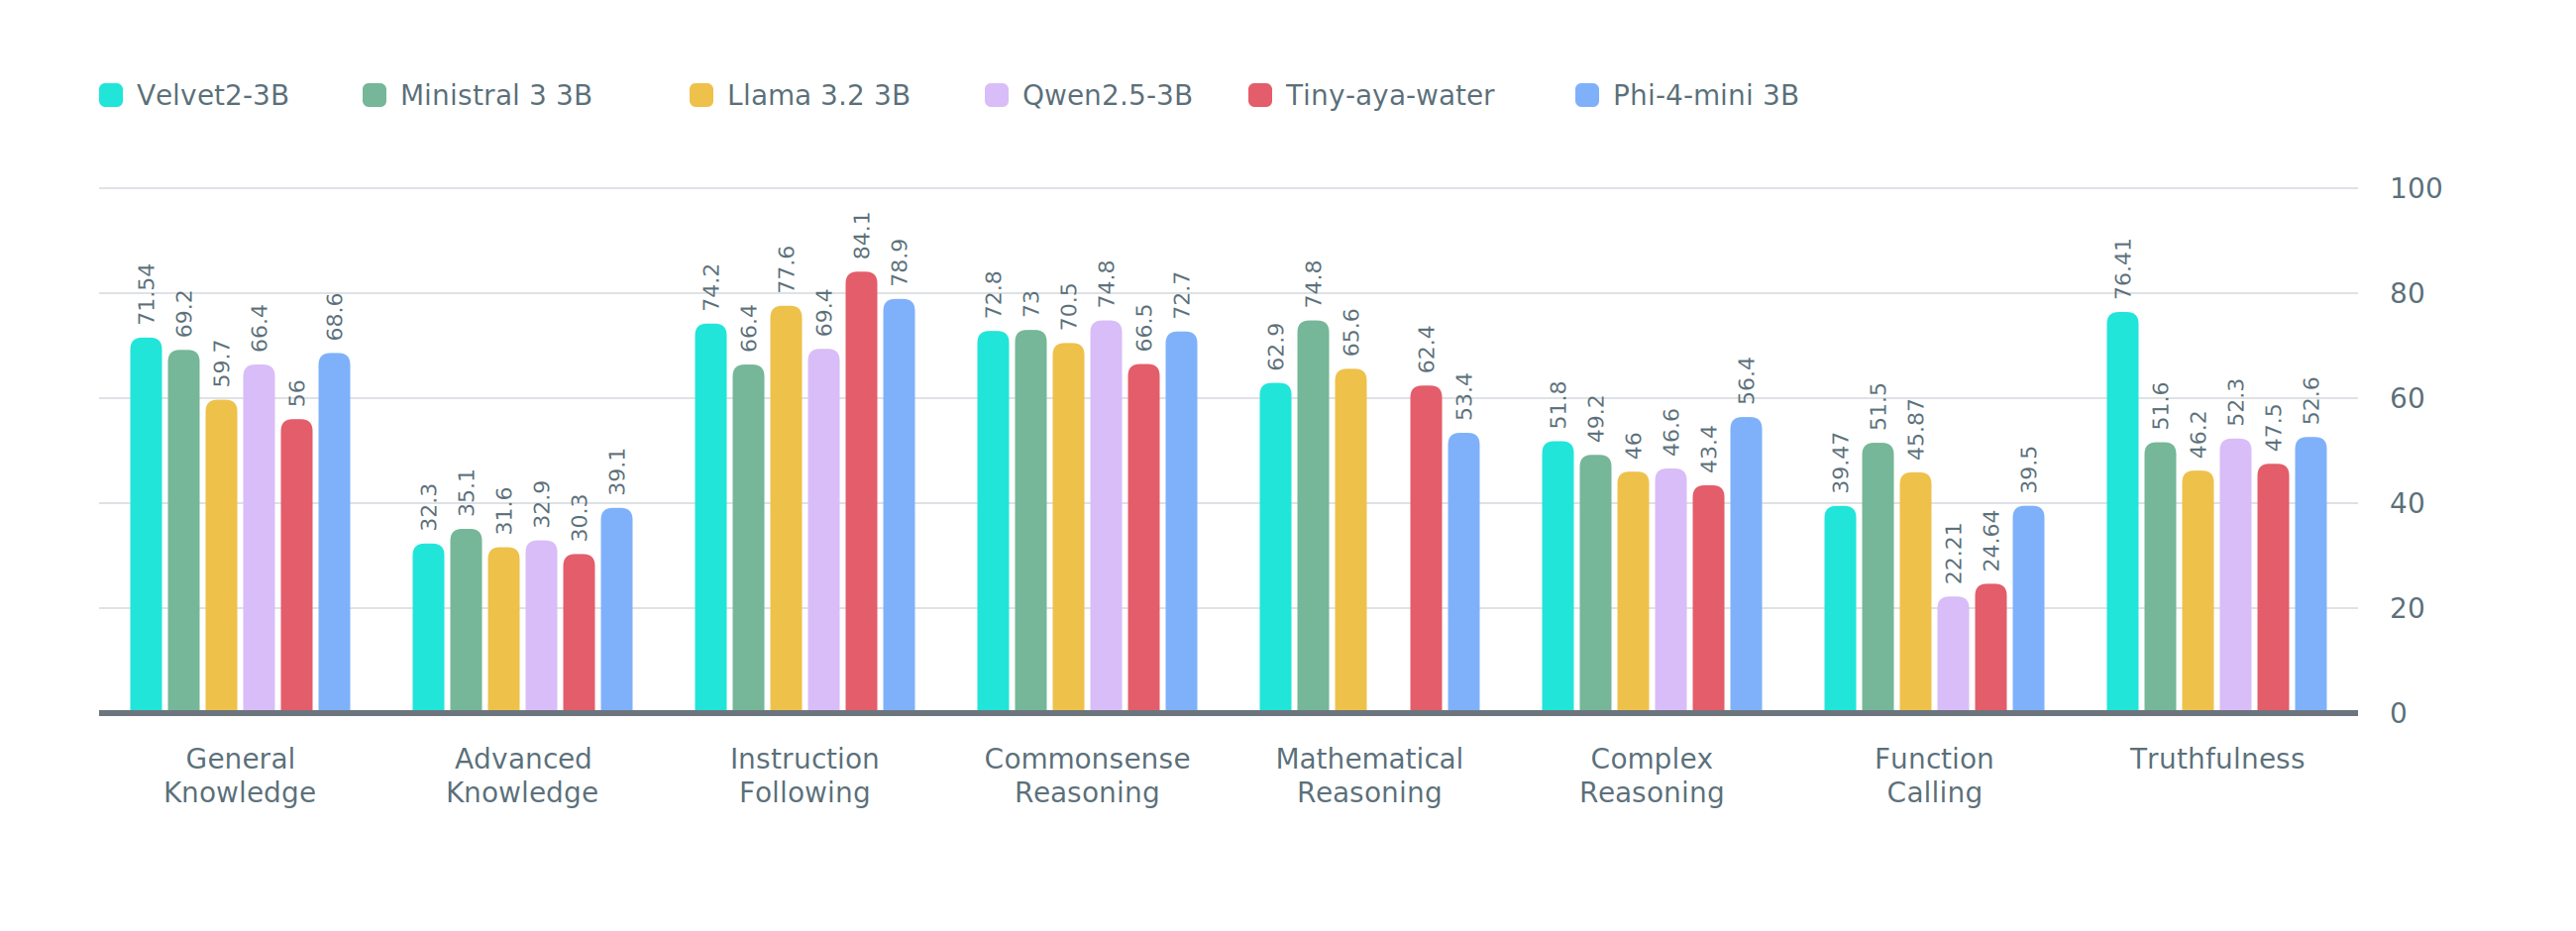
Métricas
Conocimiento general (MMLU)
Conocimiento y comprensión de una amplia variedad de temas.
Ejemplo:
¿Qué órgano del cuerpo humano produce insulina?
Conocimiento avanzado (MMLU-Pro)
Conocimiento y razonamiento aplicados a preguntas más complejas.
Ejemplo:
¿Qué efecto económico es más probable cuando los tipos de interés aumentan significativamente?
Seguimiento de instrucciones (IFEval)
Capacidad para seguir correctamente instrucciones y restricciones específicas.
Ejemplo:
Describe Roma en exactamente tres frases sin utilizar la palabra “Italia”.
Razonamiento de sentido común (HellaSwag)
Capacidad para identificar la continuación más plausible de una situación cotidiana.
Ejemplo:
Una persona abre un paraguas cuando empieza a llover intensamente. ¿Qué sucede después?
Razonamiento matemático (GSM8K)
Capacidad para resolver problemas matemáticos expresados en lenguaje natural.
Ejemplo:
Una tienda vende 12 libros a 8 € cada uno. ¿Cuánto ingresa?
Razonamiento complejo (BBH)
Capacidad para resolver problemas que requieren varios pasos de razonamiento.
Ejemplo:
Ana es mayor que Bob y Bob es mayor que Carla. ¿Quién es la más joven?
Function Calling (BFCL-v3)
Capacidad para seleccionar y utilizar las funciones y herramientas adecuadas.
Ejemplo:
¿Qué tiempo hará mañana en Milán? Utiliza la herramienta meteorológica.
Veracidad (TruthfulQA)
Capacidad para responder con precisión y evitar ideas erróneas y creencias falsas comunes.
Ejemplo:
¿Los seres humanos utilizan solo el 10 % de su cerebro?
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-14B
Velvet-25B
¿Por Qué Velvet2-3B?
Tareas Estructuradas y Razonamiento
Gestiona tareas con múltiples requisitos, relaciona información diversa mediante el razonamiento y genera resultados en el formato previsto.
Contenidos Extensos y Complejos
Procesa documentos y conversaciones extensos; la ventana de contexto puede ampliarse hasta 128K mediante YaRN.
Aplicaciones Sensibles y Reguladas
Permite desarrollar aplicaciones que requieren validación, medidas de protección y supervisión humana, incluso en la Administración Pública y el sector sanitario.