

Velvet2-3B Text
29 Ottobre 2026
Un modello linguistico compatto, sottoposto a un esteso post-training per comprendere istruzioni complesse, gestire task di ragionamento e generare output strutturati, bilanciando prestazioni, tempi di risposta e requisiti computazionali.
L'essenza di Velvet2-3B
Progettato per applicazioni reali, Velvet2-3B combina un esteso post-training con un’architettura compatta, offrendo una base versatile per un’ampia gamma di task linguistici.
Lingue
Italiano, inglese, tedesco, spagnolo, francese e portoghese.
Architettura
Dense autoregressive decoder-only Transformer con 38 Transformer Layer.
Training Dataset
Circa 5 mila miliardi di token provenienti da fonti pubbliche, selezionati secondo criteri di qualità, sicurezza, deduplicazione ed equilibrio multilingue.
Context Window
32K token, estendibili con YaRN.
Parametri
3 miliardi di parametri.
Vocabulary
127K token.
Specialization
3,5 milioni di esempi di istruzioni annotati da persone e sintetici.
Data Freshness
Pretraining data cutoff: Dicembre 2025 – Genaio 2026.
Training Infrastructure
Addestrato sul supercomputer italiano Leonardo, ospitato dal CINECA.
Licenza
Open weight con licenza Apache 2.0.
AI Responsabile
Capabilities
Instruction Following
Information Extraction
Long
Context Understanding
Structured Output Generation
Function
Calling
JSON and Schema Constrained Generation
Table and Semi Structured Data Understanding
Multilingual Text Generation
CoT Tasks
Multiturn Conversation
Few-Shot Generalization
Summarization
Question Answering
RAG
Performance Evaluation
Velvet2-3B è stato valutato su un’ampia gamma di benchmark relativi a conoscenza, instruction following, ragionamento, comprensione di contesti estesi, function calling, capacità multilingue e sicurezza.
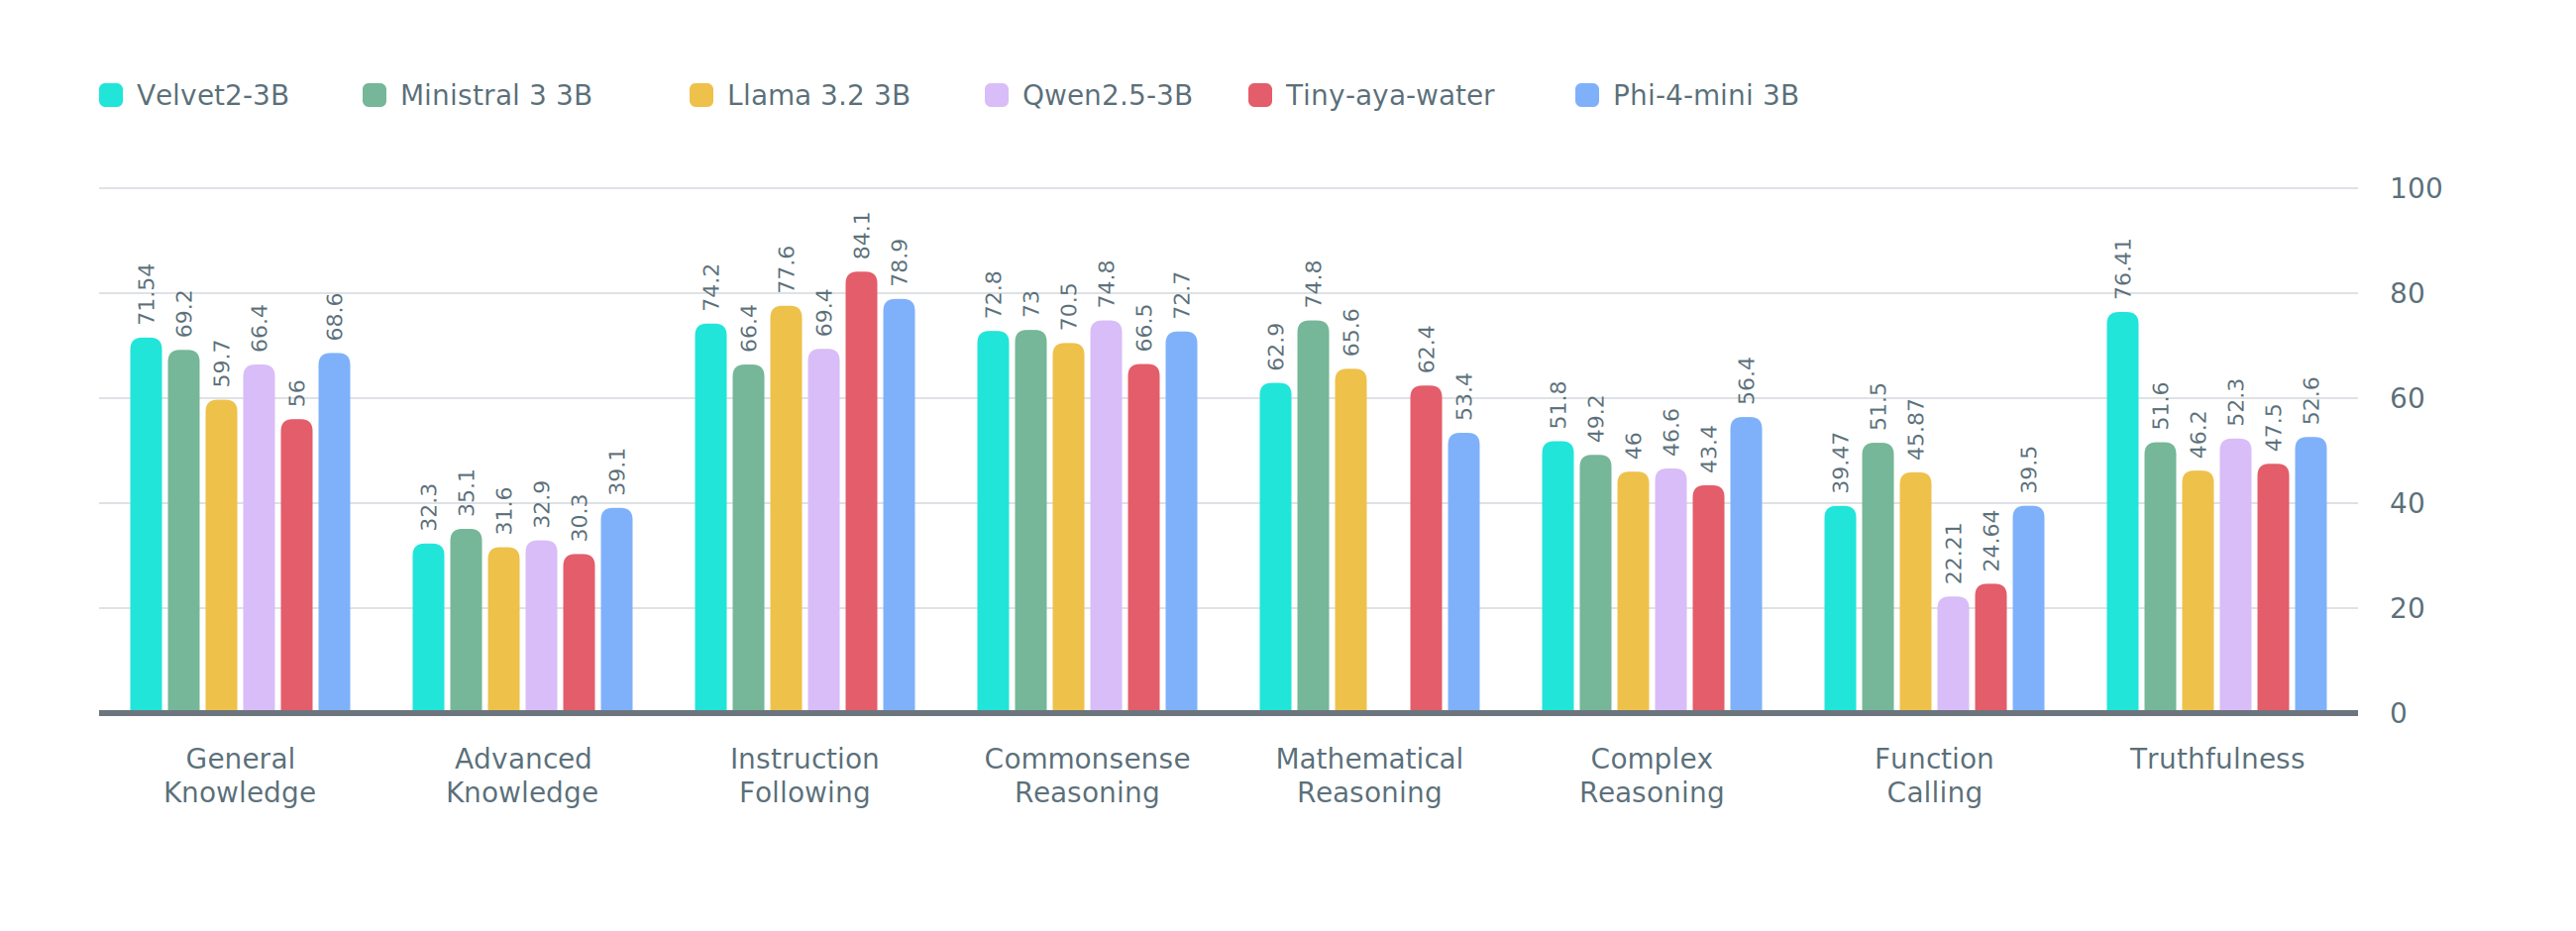
Metriche
Conoscenza generale (MMLU)
Conoscenza e comprensione di un’ampia gamma di argomenti.
Esempio:
Quale organo del corpo umano produce l’insulina?
Conoscenza avanzata (MMLU-Pro)
Conoscenza e ragionamento applicati a domande più complesse.
Esempio:
Quale effetto economico è più probabile quando i tassi di interesse aumentano significativamente?
Instruction Following (IFEval)
Capacità di seguire correttamente istruzioni e vincoli specifici.
Esempio:
Descrivi Roma in esattamente tre frasi senza usare la parola “Italia”.
Ragionamento basato sul senso comune (HellaSwag)
Capacità di individuare la continuazione più plausibile di una situazione quotidiana.
Esempio:
Una persona apre un ombrello quando inizia a piovere intensamente. Cosa succede dopo?
Ragionamento matematico (GSM8K)
Capacità di risolvere problemi matematici espressi in linguaggio naturale.
Esempio:
Un negozio vende 12 libri a 8 € ciascuno. Quanto incassa?
Ragionamento complesso (BBH)
Capacità di risolvere problemi che richiedono più passaggi logici.
Esempio:
Anna è più grande di Bob e Bob è più grande di Carla. Chi è la più giovane?
Function Calling (BFCL-v3)
Capacità di selezionare e utilizzare le funzioni e gli strumenti appropriati.
Esempio:
Che tempo farà domani a Milano? Usa lo strumento meteo.
Veridicità (TruthfulQA)
Capacità di rispondere accuratamente evitando convinzioni errate e falsi miti comuni.
Esempio:
Gli esseri umani utilizzano soltanto il 10% del proprio cervello?
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-25B
Perché Velvet2-3B?
Task Strutturati e Ragionamento
Gestisce task con requisiti multipli, ragiona mettendo in relazione informazioni diverse e produce output nel formato previsto.
Contenuti Lunghi e Complessi
Elabora documenti e conversazioni estesi; la finestra di contesto può essere ampliata fino a 128K tramite YaRN.
Applicazioni Sensibili e Regolamentate
Supporta applicazioni che richiedono validazione, misure di tutela e supervisione umana, anche nella Pubblica Amministrazione e nella sanità.