

Velvet2-3B Speech
29 ottobre 2026
Un modello multilingue per l’analisi del parlato, progettato per comprendere i contenuti orali andando oltre le parole e cogliendo le informazioni veicolate attraverso il parlato, così da svolgere task linguistici complessi direttamente dall’audio.
L'essenza di Velvet2-3B Speech
Velvet2-3B-Speech si basa sul foundation model linguistico Velvet2 e ne integra le capacità di elaborazione del parlato, creando un modello versatile per le applicazioni in cui la voce rappresenta una fonte naturale di informazioni.
Lingue
Inglese, italiano, spagnolo, portoghese, francese e tedesco.
Architettura
Modello linguistico Velvet2-3B, encoder audio Whisper Large v3 e un proiettore dedicato.
Training Dataset
Quasi 30 milioni di esempi audio in sei lingue, per un totale di circa 95.000 ore di parlato.
Context Window
32K token. Può processare fino a circa 22 minuti di audio.
AI Responsabile
Le misure di sicurezza riguardano la selezione dei dati, l’addestramento, il post-addestramento, la valutazione e la governance.
Parametri
Modello linguistico da 3 Miliardi di parametri, più un encoder audio da 0,7 Miliardi.
Data Freshness
Data Cutoff dei dati di preaddestramento: dicembre 2025 – gennaio 2026.
Licenza
Open-weight con licenza Apache 2.0.
Capabilities
Automatic Speech Recognition
Information Extraction
Speech Translation
Speech Emotion Recognition
Function
Calling From Speech
Language
Identification
Instruction Following
Question Answering From Speech
Multiturn Conversation
Structured Output Generation
Summarization From Speech
Performance Evaluation
Velvet2-3B-Speech è stato valutato su una serie di benchmark relativi al riconoscimento vocale, alla comprensione del linguaggio parlato, alla traduzione e al riconoscimento delle emozioni.
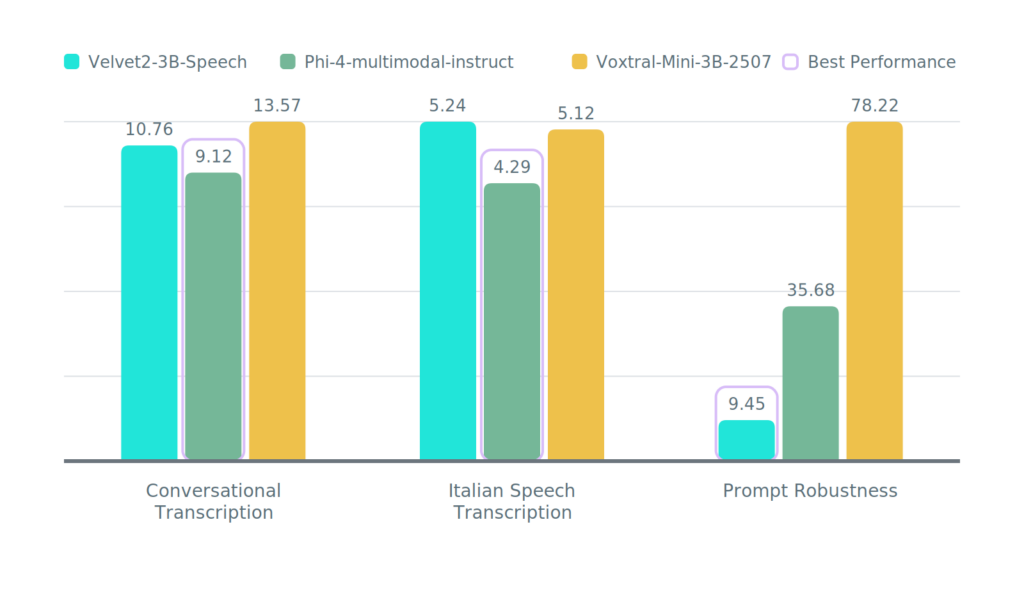
Transcription & Robustness
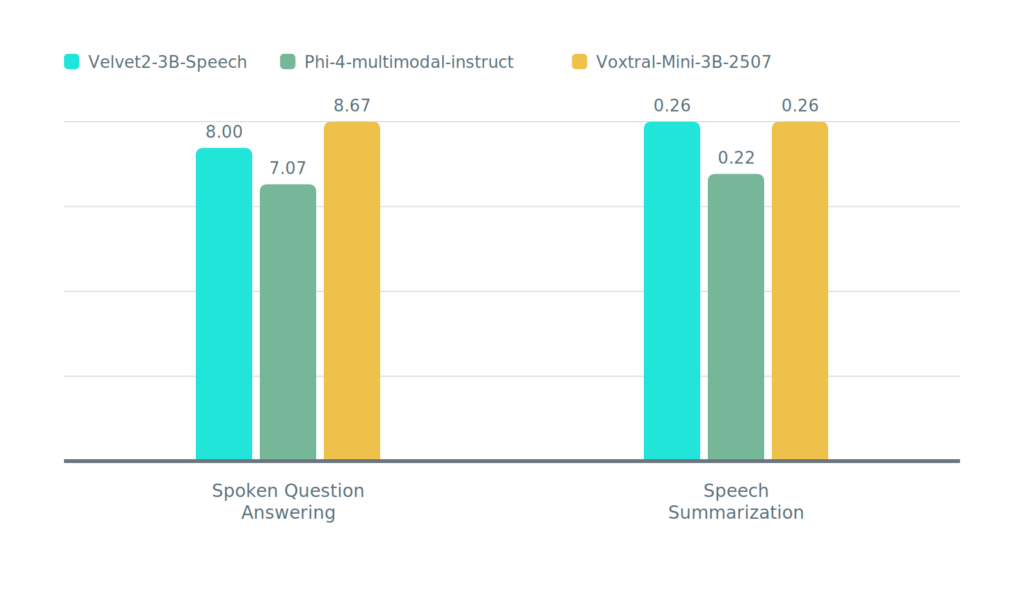
Speech Understanding
Metriche
Trascrizione di conversazioni (AMI)
Misura l’accuratezza della trascrizione di conversazioni e riunioni reali.
Esempio di prompt: “Trascrivi accuratamente questa conversazione.”
Trascrizione del parlato in italiano (Multilingual ASR Italian)
Misura l’accuratezza della trascrizione del parlato in italiano.
Esempio di prompt: “Trascrivi questo audio in italiano.”
Robustezza rispetto ai prompt (DOWIS)
Misura la coerenza della trascrizione con istruzioni formulate in modi diversi.
Esempio di prompt: “Trascrivi esattamente ciò che viene detto.”
Risposta a domande orali (HeySquad EN)
Misura la capacità di comprendere le domande formulate oralmente e fornire risposte appropriate.
Esempio di prompt: “Ascolta la domanda e dammi la risposta.”
Sintesi del parlato (VoxPopuli-L EN)
Misura la capacità di sintetizzare contenuti orali di lunga durata.
Esempio di prompt: “Sintetizza i punti principali di questa registrazione.”
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-25B
Perché Velvet2-3B Speech?
Contenuti audio e multimediali
Trasforma i contenuti parlati in informazioni che possono essere analizzate, sintetizzate e interrogate, cogliendo segnali aggiuntivi come le emozioni.
Contenuti vocali multilingue
Supporta le interazioni vocali in ambienti multilingue, comprese le conversazioni in cui i parlanti passano da una lingua all’altra.
Task linguistici a partire dal parlato
Utilizza la voce come punto di partenza per il question answering, la sintesi e l’attivazione di funzioni, senza fermarsi alla trascrizione.