

Velvet2-3B Speech
29 de outubro de 2026
Um modelo multilíngue para análise da fala, projetado para compreender conteúdos falados para além das palavras e captar as informações transmitidas pela fala, permitindo realizar tarefas linguísticas complexas diretamente a partir do áudio.
A Essência do Velvet2-3B Vision
O Velvet2-3B-Speech se baseia no foundation model de linguagem Velvet2 e integra o processamento de fala, criando um modelo versátil para aplicações em que a voz é uma fonte natural de informação.
Idiomas
Italiano, inglês, alemão, espanhol, francês e português.
Arquitetura
Modelo de linguagem Velvet2-3B, codificador de áudio Whisper Large v3 e um projetor dedicado.
Training Dataset
Quase 30 milhões de exemplos de áudio em seis idiomas, totalizando aproximadamente 95.000 horas de fala.
Parâmetros
Modelo de linguagem de 3B, mais um codificador de áudio de 0,7B.
Context Window
32K tokens e até aproximadamente 22 minutos de áudio.
IA Responsável
Medidas de segurança integradas à curadoria de dados, ao treinamento e ao pós-treinamento, incluindo filtragem de dados, controles de qualidade, alinhamento e avaliação de segurança, apoiadas por processos contínuos de governança e supervisão interna.
Vocabulário
127K Tokens.
Data Freshness
Data-limite dos dados de pré-treinamento: dezembro de 2025 – janeiro de 2026.
Licença
Open-weight com licença Apache 2.0.
Capacidades
Reconhecimento automático de fala
Extração de informações
Tradução de fala
Reconhecimento de emoções na fala
Function Calling a partir da fala
Identificação do idioma
Compreensão de instruções
Resposta a perguntas a partir da fala
Conversas multiturno
Geração de resultados estruturados
Sumarização a partir da fala
Performance Evaluation
O Velvet2-3B-Speech foi avaliado em uma série de benchmarks que abrangem reconhecimento de fala, compreensão da linguagem falada, tradução e reconhecimento de emoções.
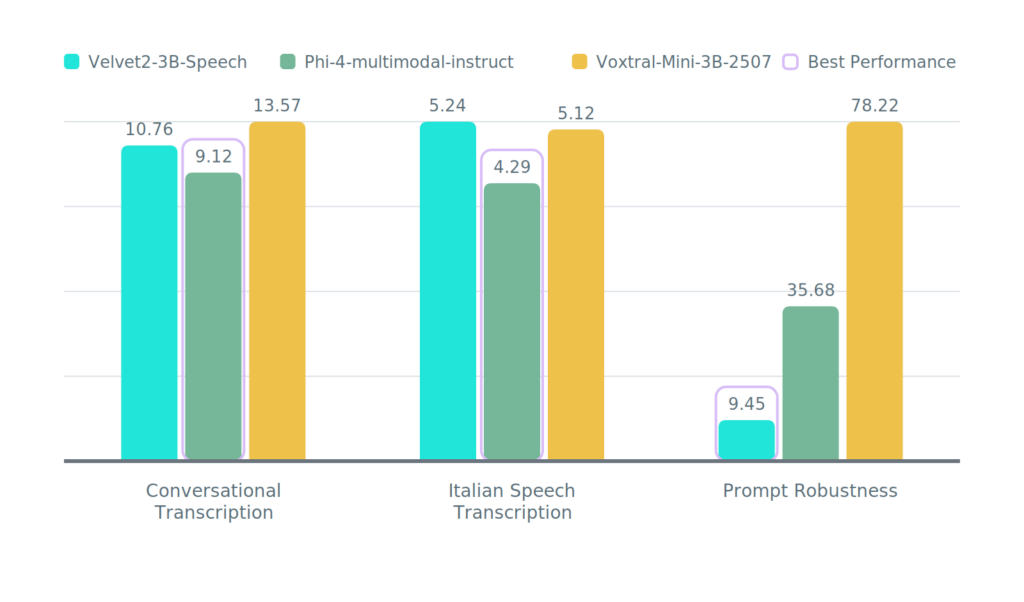
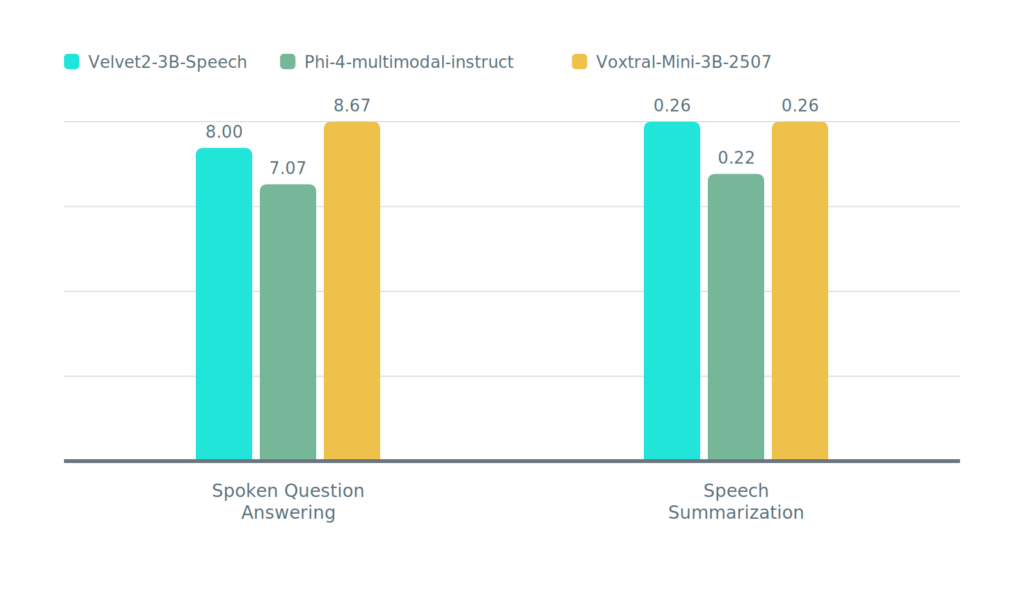
Métricas
Transcrição de conversas (AMI)
Mede a precisão da transcrição de conversas e reuniões reais.
Exemplo de prompt:
“Transcreva esta conversa com precisão.”
Transcrição da fala em italiano (Multilingual ASR Italian)
Mede a precisão da transcrição do italiano falado.
Exemplo de prompt:
“Transcreva este áudio em italiano.”
Robustez em relação aos prompts (DOWIS)
Mede a consistência da transcrição com instruções formuladas de maneiras diferentes.
Exemplo de prompt:
“Transcreva exatamente o que está sendo dito.”
Resposta a perguntas faladas (HeySquad EN)
Mede a capacidade de compreender e responder perguntas formuladas oralmente.
Exemplo de prompt:
“Ouça a pergunta e me dê a resposta.”
Sumarização da fala (VoxPopuli-L EN)
Mede a capacidade de resumir conteúdos falados extensos.
Exemplo de prompt:
“Resuma os pontos principais desta gravação.”
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-14B
Velvet-25B
Velvet2-3B speech
Por Que Escolher o Velvet2-3B Vision?
Conteúdos de áudio e multimídia
Transforma conteúdos falados em informações que podem ser analisadas, resumidas e consultadas, captando sinais adicionais, como emoções.
Conteúdos de voz multilíngues
Permite interações de voz em ambientes multilíngues, incluindo conversas em que os falantes alternam entre idiomas.
Tarefas linguísticas a partir da fala
Utiliza a voz como ponto de partida para responder perguntas, resumir e acionar funções, em vez de se limitar à transcrição.