

Velvet2-3B Vision
29 de octubre de 2026
Un modelo de visión y lenguaje compacto y multilingüe, diseñado para comprender conjuntamente imágenes y texto, habilitando el razonamiento multimodal, la comprensión visual y el análisis de documentos.
La Esencia deVelvet2-3B Vision
Basado en Velvet2-3B, el modelo amplía sus capacidades a tareas visuales, como la comprensión de imágenes, el análisis de documentos, la respuesta a preguntas sobre contenidos visuales y la extracción de información.
Idiomas
Italiano, inglés, alemán, español, francés y portugués.
Arquitectura
Arquitectura multimodal que combina el modelo de lenguaje Velvet2-3B, un codificador visual SigLIP2 y un proyector específico que conecta las representaciones visuales y lingüísticas.
Training Dataset
Entrenamiento multimodal basado en datasets de pares imagen-texto y de instrucciones en seis idiomas, seleccionados cuidadosamente para equilibrar la representación lingüística y reducir el predominio del inglés.
IA Responsable
Medidas de seguridad integradas en la selección de datos, el entrenamiento y el postentrenamiento, como filtrado de datos, controles de calidad, alineación y evaluación de la seguridad, respaldadas por procesos continuos de gobernanza y supervisión interna.
Parámetros
Modelo de lenguaje: 3B. Codificador visual: 433M. Proyector MLP: 14,69M. Adaptadores LoRA: 249M.
Context Window
32K Tokens.
Vocabulario
127K Tokens.
Data Freshness
Fecha límite de los datos de preentrenamiento: diciembre de 2025 – enero de 2026.
Especialización
Dos fases: 905K muestras de imagen-texto por época para la alineación multimodal, seguidas de 1,25M de muestras de instrucciones multimodales por época para el ajuste mediante instrucciones.
Licencia
Open-weight con licencia Apache 2.0.
Capacidades
Generación de descripciones de imágenes
Visual Question Answering (VQA)
Comprensión de documentos
OCR-Enhanced Reasoning
Extracción de información
Visual Reasoning
Comprensión de gráficos, diagramas y tablas
Recuento de objetos
Comprensión espacial
Procesamiento de entradas con múltiples imágenes
Performance Evaluation
Velvet2-3B-Vision se evaluó en una amplia variedad de benchmarks que abarcan image captioning, visual question answering, comprensión de documentos, OCR y razonamiento multimodal.
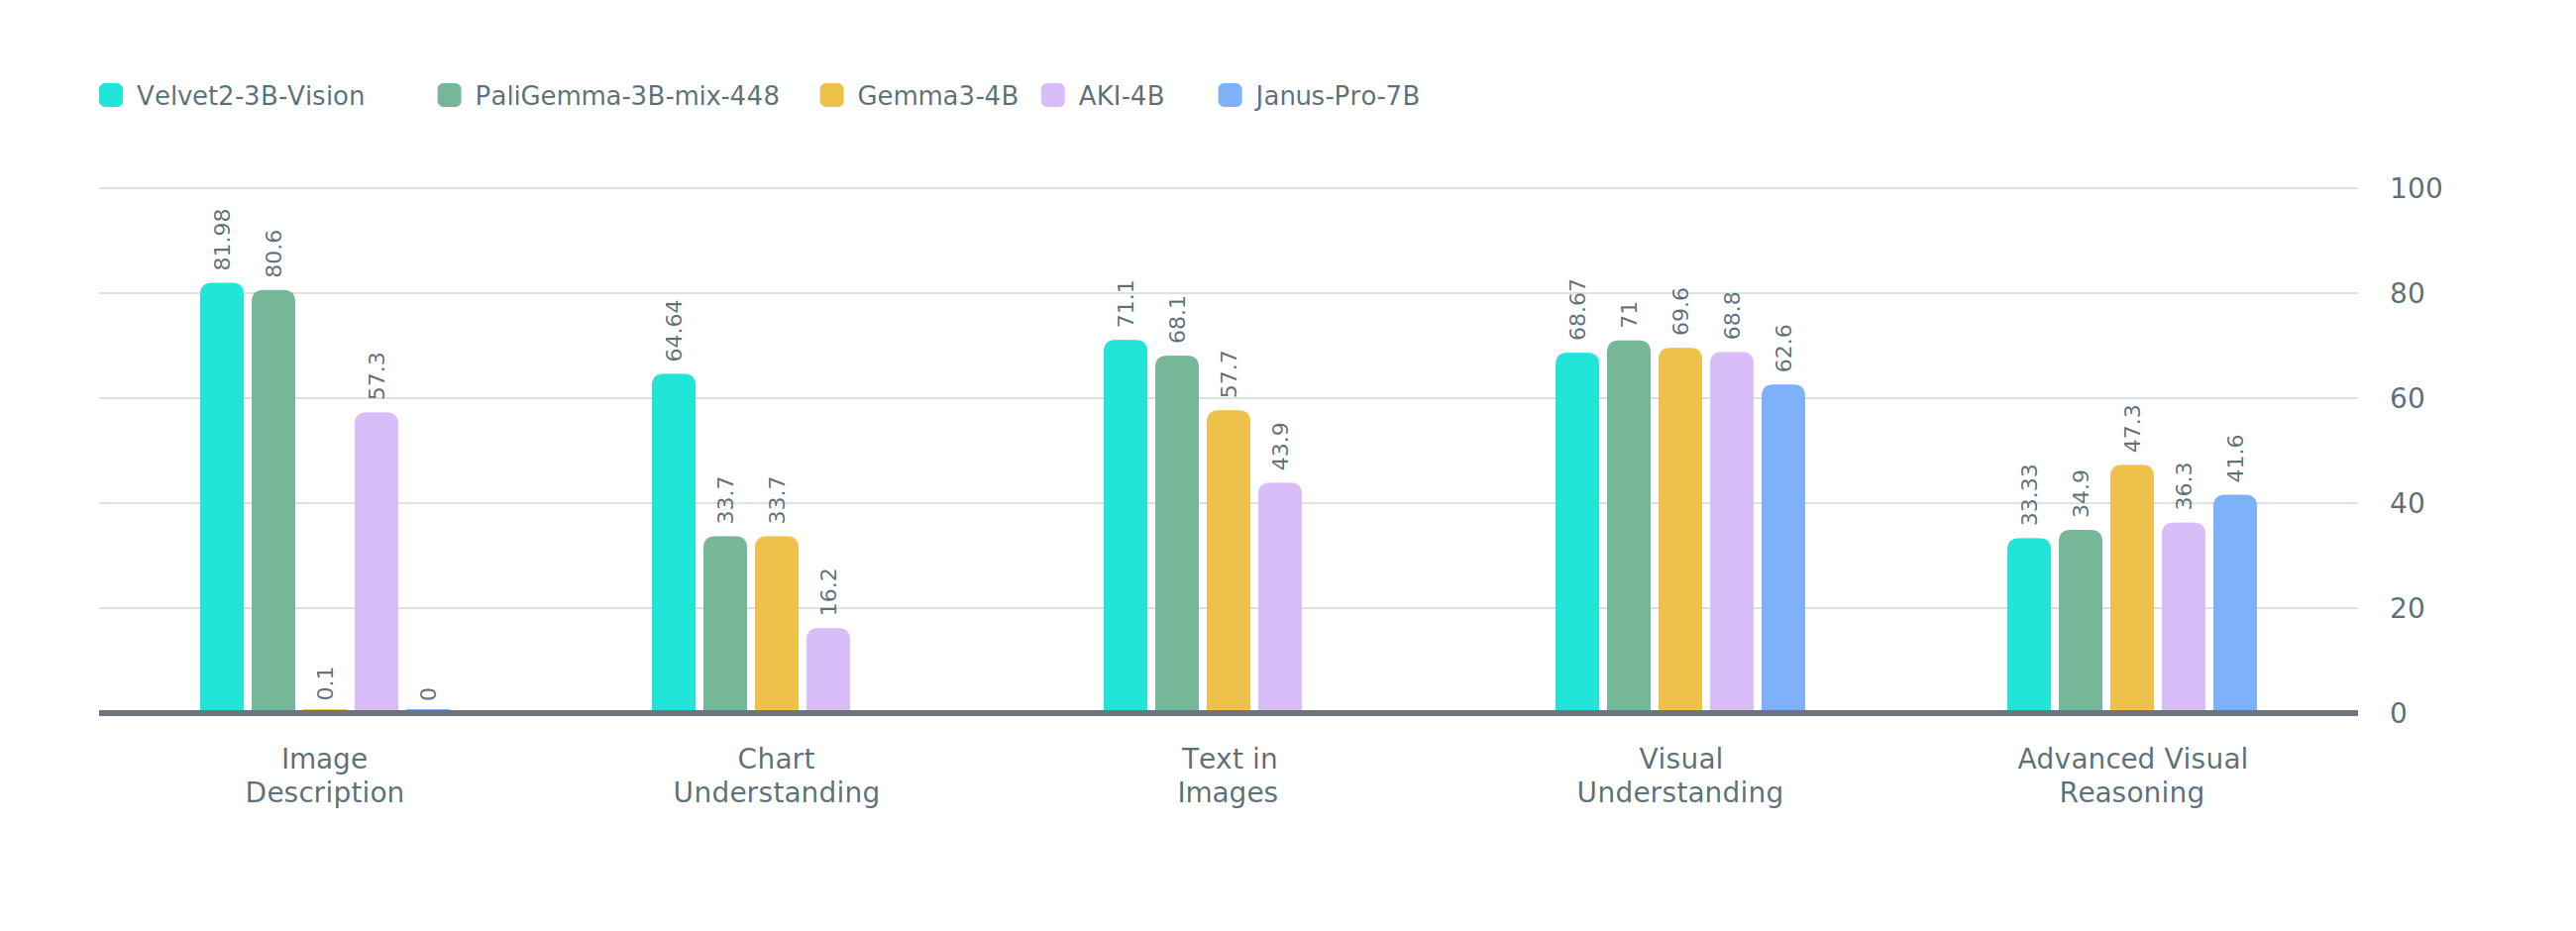
Métricas
Descripción de imágenes (COCO CIDEr)
Mide la capacidad del modelo para describir una imagen.
Ejemplo de prompt:
“Describe esta imagen en detalle.”
Comprensión de gráficos (ChartQA)
Mide la capacidad del modelo para comprender gráficos y los datos que contienen.
Ejemplo de prompt:
“¿Qué año presenta el valor más alto en este gráfico?”
Texto en imágenes (TextVQA)
Mide la comprensión del texto que aparece dentro de las imágenes.
Ejemplo de prompt:
“¿Qué dice el cartel de esta imagen?”
Comprensión de documentos (DocVQA)
Mide la capacidad del modelo para encontrar información en documentos visuales.
Ejemplo de prompt:
“¿Cuál es el importe total indicado en esta factura?”
Comprensión visual (MMBench)
Mide la capacidad general de comprensión y razonamiento sobre imágenes y preguntas.
Ejemplo de prompt:
“¿Qué objeto podría utilizarse para cortar el papel?”
Razonamiento visual avanzado (MMMU)
Mide la capacidad de realizar razonamientos complejos utilizando imágenes, diagramas y conocimientos especializados.
Ejemplo de prompt:
“¿Qué fuerza actúa sobre el objeto representado en este diagrama?”
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-14B
Velvet-25B
¿Por Qué Velvet2-3B Vision?
Comprensión de documentos complejos
Analiza la información distribuida entre textos, tablas, gráficos y otros elementos visuales.
Comprensión visual multilingüe
Procesa descripciones de imágenes y textos de documentos en varios idiomas y responde a preguntas sobre contenidos visuales.
Múltiples entradas visuales
Conecta, en una única interacción, la información distribuida entre varias imágenes o páginas de documentos.