

Velvet2-3B Vision
October 29, 2026
A compact, multilingual vision-language model designed to jointly understand images and text, enabling multimodal reasoning, visual understanding and document analysis.
The essence of Velvet2-3B Vision
Built upon Velvet2-3B, the model extends its capabilities to visual tasks, including image understanding, document analysis, visual question answering and information extraction.
Languages
Italian, English, German, Spanish, French and Brazilian Portuguese.
Architecture
Multimodal architecture combining the Velvet2-3B language model, a SigLIP2 vision encoder and a dedicated projector connecting visual and language representations.
Training Dataset
Multimodal training based on image-text and instruction datasets across six languages, deliberately curated to balance linguistic representation and reduce English dominance.
Responsible AI
Safety measures integrated across data curation, training and post-training, including data filtering, quality controls, alignment and safety evaluation, supported by continuous internal governance and oversight.
Parameters
Language model 3B. Vision encoder 433M. MLP Projector 14.69M. LoRA adapters 249M.
Context Window
32K Tokens.
Vocabulary
127K Tokens.
Data Freshness
Pretraining data cutoff: December 2025 – January 2026.
Specialization
License
Open weight with Apache 2.0 license.
Capabilities
Image Captioning
Visual Question Answering (VQA)
Document Understanding
OCR-Enhanced Reasoning
Information Extraction
Visual Reasoning
Chart, Diagram, Table Understanding
Object Counting
Spatial Understanding
Multi-image Input Processing
Performance Evaluation
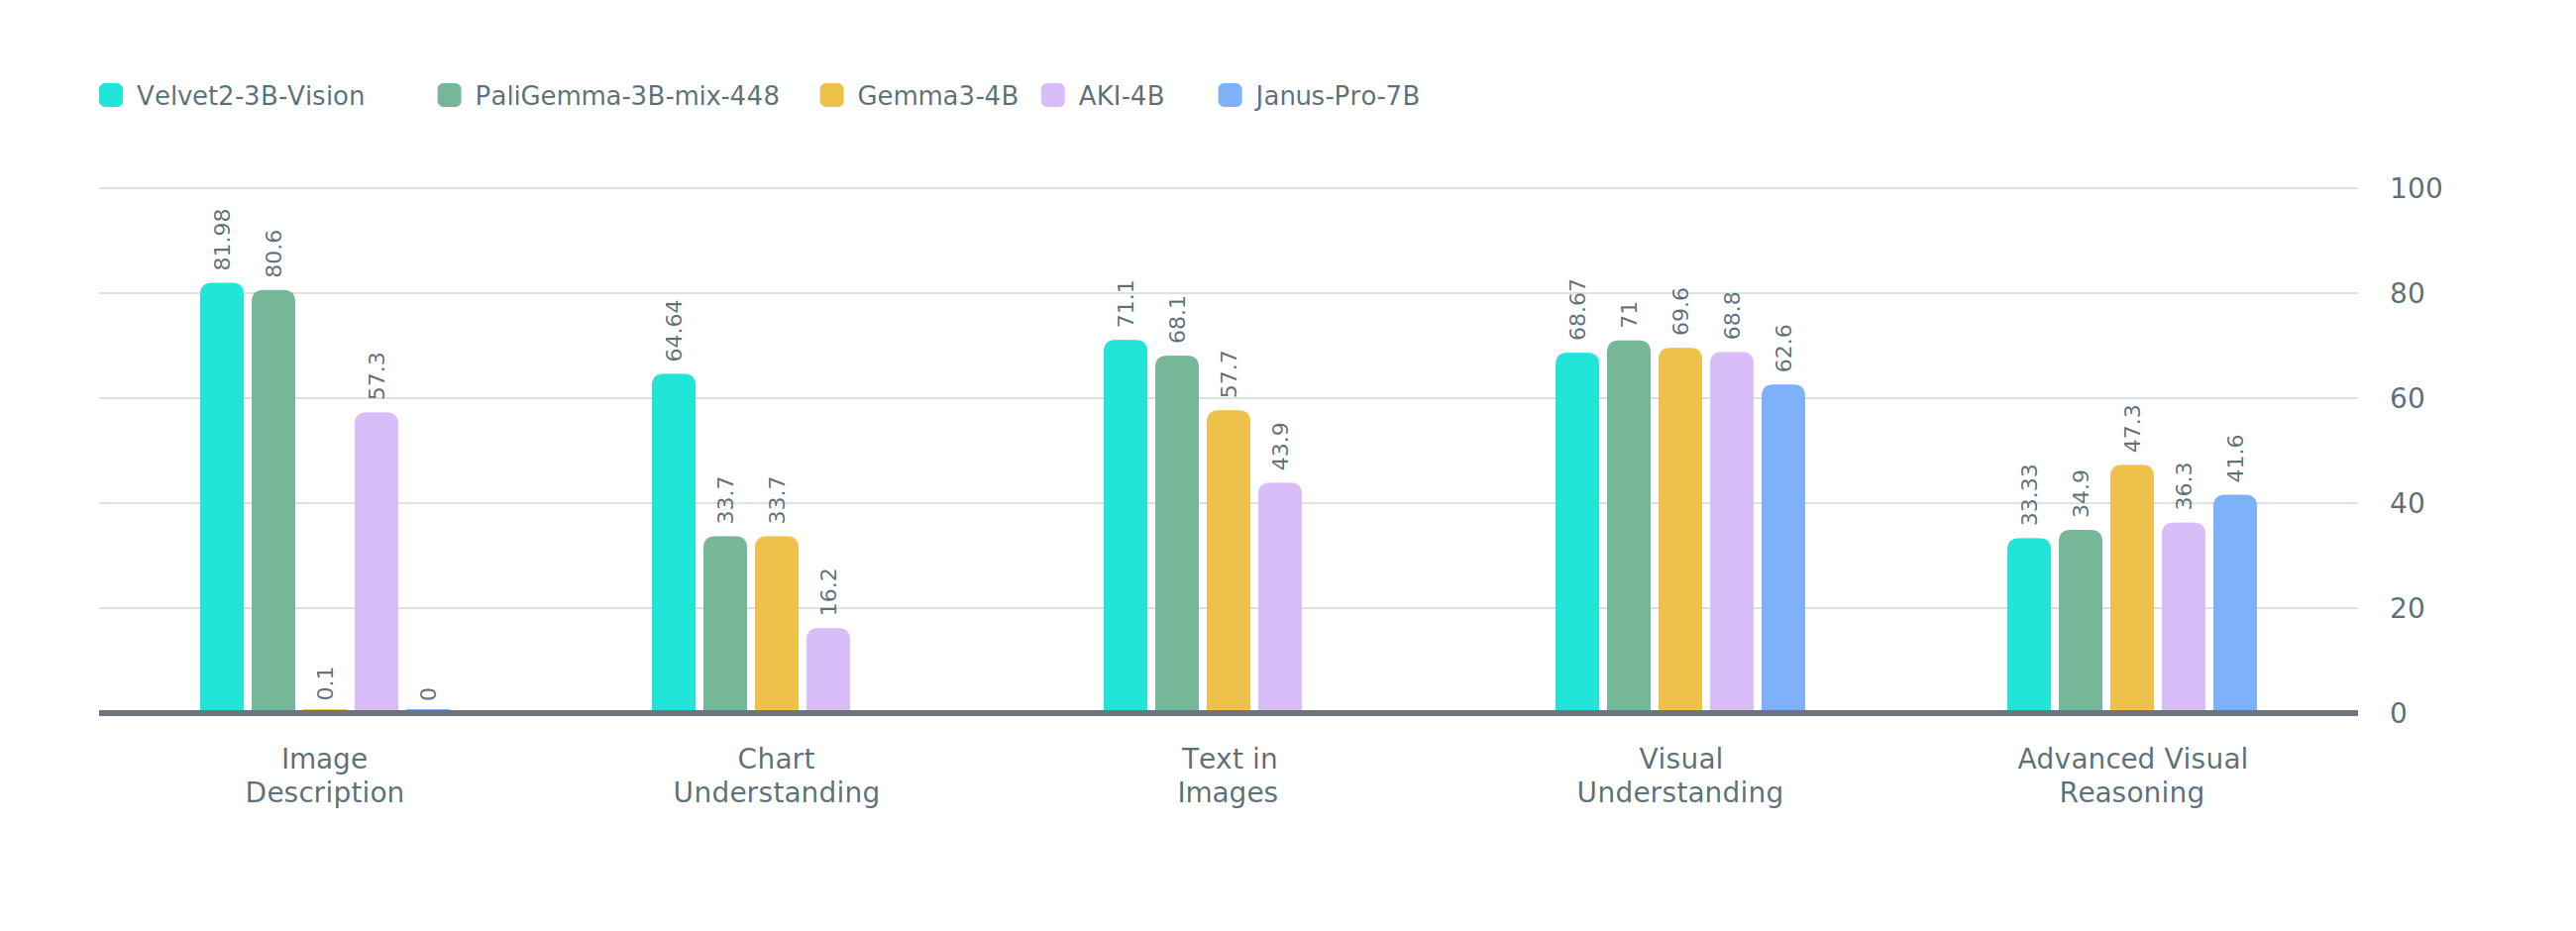
Velvet2-3B-Vision was evaluated across a broad range of benchmarks covering image captioning, visual question answering, document understanding, OCR and multimodal reasoning.
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Metrics
Image Description (COCO CIDEr)
Measures how well the model describes an image.
Example prompt:
“Describe this image in detail.”
Chart Understanding (ChartQA)
Measures how well the model understands charts and their data.
Example prompt:
“Which year has the highest value in this chart?”
Text in Images (TextVQA)
Measures understanding of text appearing inside images.
Example prompt:
“What does the sign in this image say?”
Document Understanding (DocVQA)
Measures how well the model finds information in visual documents.
Example prompt:
“What is the total amount shown on this invoice?”
Visual Understanding (MMBench)
Measures general understanding and reasoning across images and questions.
Example prompt:
“Which object could be used to cut the paper?”
Advanced Visual Reasoning (MMMU)
Measures complex reasoning using images, diagrams and specialist knowledge.
Example prompt:
“Which force acts on the object shown in this diagram?”
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-14B
Velvet-25B
Velvet2-3B text
Velvet2-3B vision
Why Velvet2-3B Vision?
Complex Document Understanding
Analyze documents where information is distributed across text, tables, charts and other visual elements, extracting and reasoning over their content.
Multilingual Visual Understanding
Multilingual capabilities extend beyond text-only interactions to visual content, allowing the model to work with multilingual image captions, text within documents and visual question answering across different languages.
Multiple Visual Inputs
Work with multiple images or document pages within the same interaction, connecting information distributed across different visual inputs.