

Velvet2-3B Vision
29 Ottobre 2026
Un modello visivo-linguistico compatto e multilingue, progettato per comprendere congiuntamente immagini e testo, abilitando il ragionamento multimodale, la comprensione visiva e l’analisi dei documenti.
L'essenza di Velvet2-3B Vision
Basato su Velvet2-3B, il modello ne estende le capacità ai task visuali, tra cui la comprensione delle immagini, l’analisi dei documenti, la risposta a domande sui contenuti visivi e l’estrazione di informazioni.
Lingue
Italiano, inglese, tedesco, spagnolo, francese e portoghese.
Architettura
Architettura multimodale che combina il modello linguistico Velvet2-3B, un encoder visivo SigLIP2 e un proiettore dedicato che collega le rappresentazioni visive e linguistiche.
Training Dataset
Addestramento multimodale basato su dataset di coppie immagine-testo e di istruzioni in sei lingue, selezionati con cura per bilanciare la rappresentazione linguistica e ridurre la predominanza dell’inglese.
AI Responsabile
Misure di sicurezza integrate nella selezione dei dati, nell’addestramento e nel post-addestramento, tra cui filtraggio dei dati, controlli di qualità, allineamento e safety evaluation, supportate da processi continui di governance e supervisione interna.
Parametri
Modello linguistico: 3B. Encoder visivo: 433M. Proiettore MLP: 14,69M. Adattatori LoRA: 249M.
Context Window
32K Tokens.
Vocabulary
127K Tokens.
Data Freshness
Data Cutoff dei dati di preaddestramento: dicembre 2025 – gennaio 2026.
Specializzazione
Due fasi: 905K sample di coppie immagine-testo per epoca per l’allineamento multimodale, seguiti da 1,25M di istruzioni multimodali per epoca per l’instruction tuning.
Licenza
Open-weight con licenza Apache 2.0.
Capabilities
Image Captioning
Visual Question Answering (VQA)
Document Understanding
OCR-Enhanced Reasoning
Information Extraction
Visual Reasoning
Chart, Diagram, Table Understanding
Object Counting
Spatial Understanding
Multi-image Input Processing
Performance Evaluation
Velvet2-3B-Vision è stato valutato su un’ampia gamma di benchmark che coprono image captioning, visual question answering, comprensione dei documenti, OCR e ragionamento multimodale.
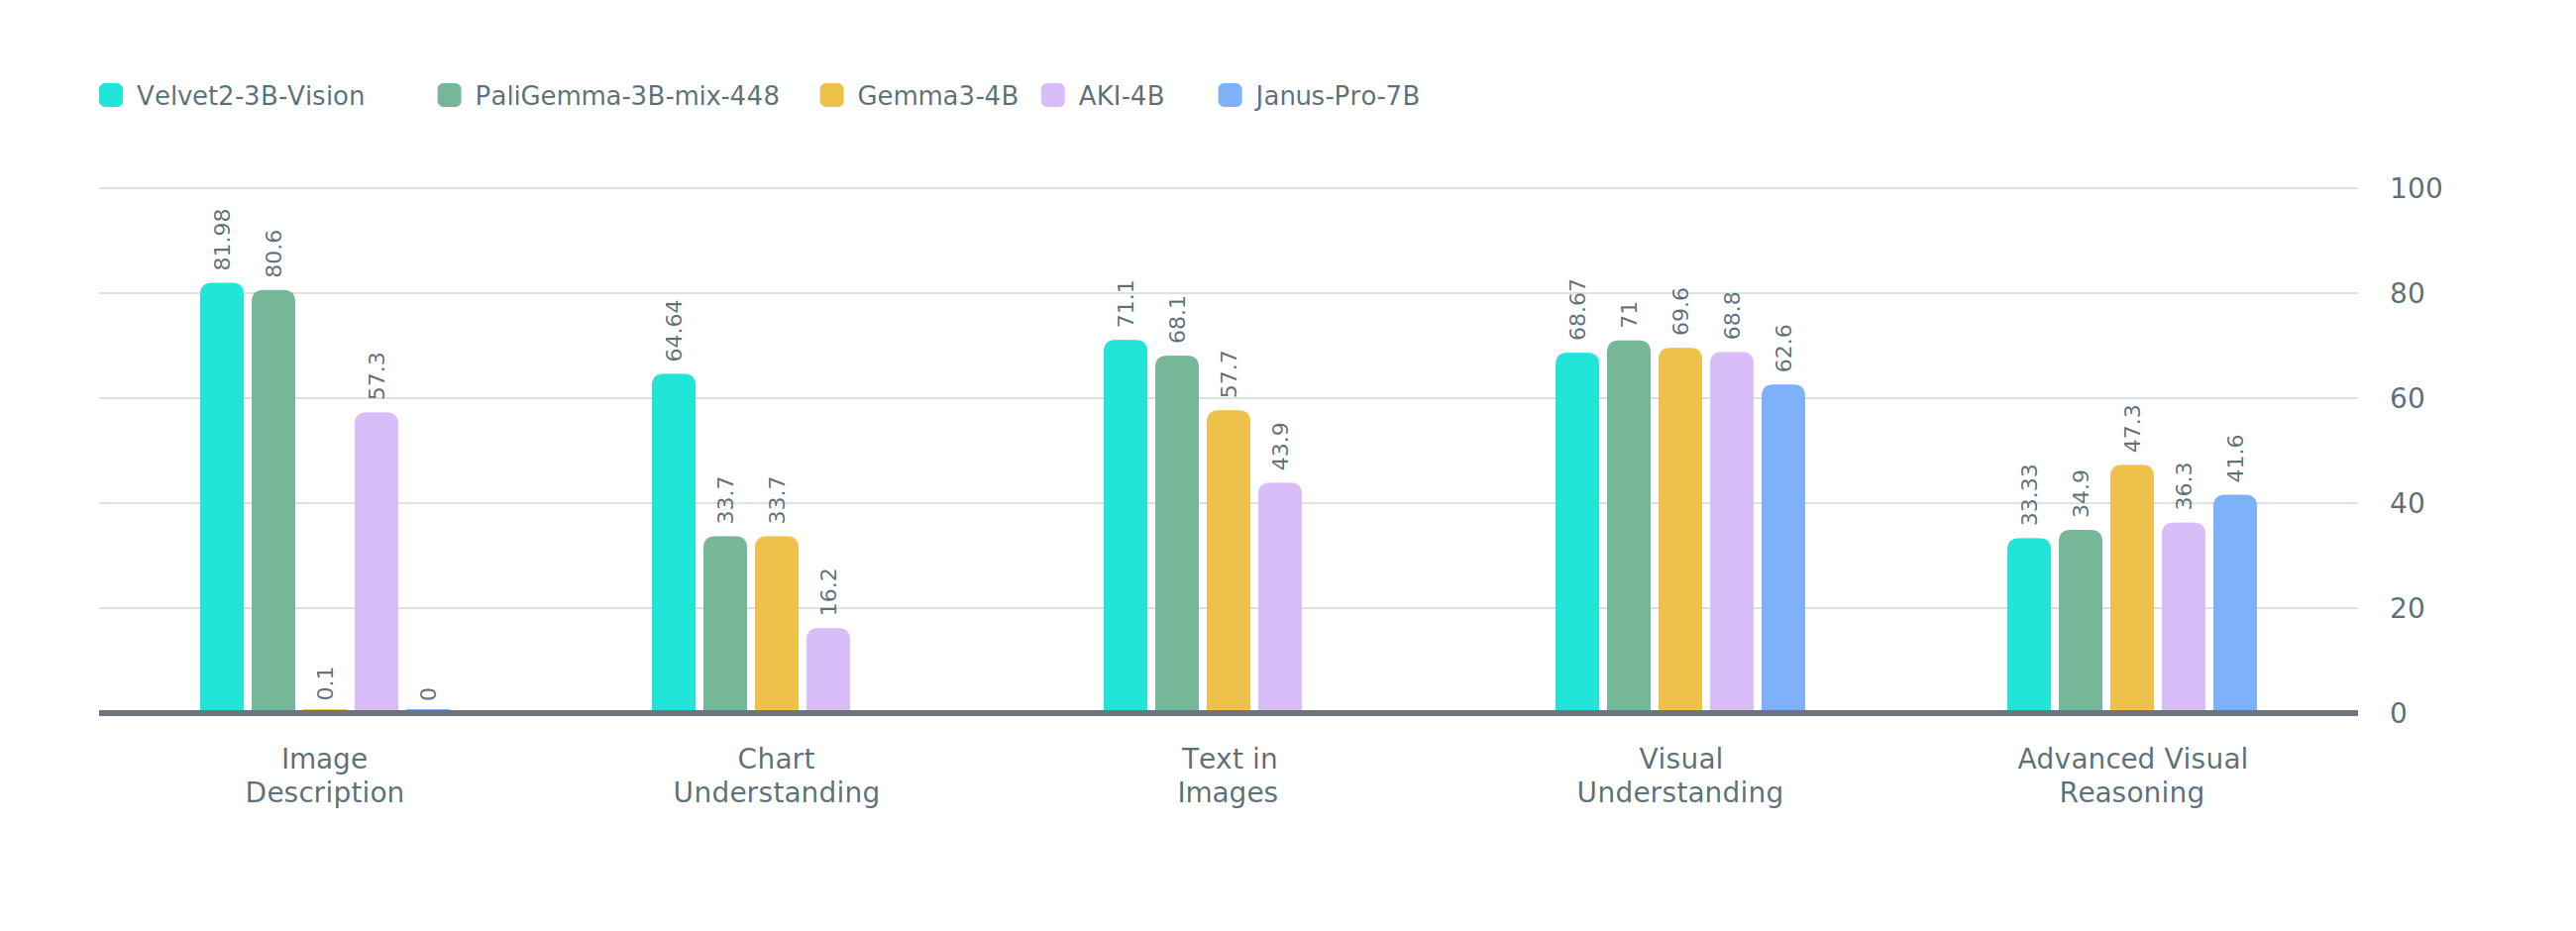
Metriche
Descrizione delle immagini (COCO CIDEr)
Misura la capacità del modello di descrivere un’immagine.
Esempio di prompt:
“Descrivi questa immagine in dettaglio.”
Comprensione dei grafici (ChartQA)
Misura la capacità del modello di comprendere i grafici e i dati che contengono.
Esempio di prompt:
“Quale anno presenta il valore più alto in questo grafico?”
Testo nelle immagini (TextVQA)
Misura la comprensione del testo presente all’interno delle immagini.
Esempio di prompt:
“Cosa c’è scritto sul cartello in questa immagine?”
Comprensione dei documenti (DocVQA)
Misura la capacità del modello di trovare informazioni nei documenti visivi.
Esempio di prompt:
“Qual è l’importo totale indicato in questa fattura?”
Comprensione visiva (MMBench)
Misura la capacità generale di comprensione e ragionamento su immagini e domande.
Esempio di prompt:
“Quale oggetto potrebbe essere utilizzato per tagliare la carta?”
Ragionamento visivo avanzato (MMMU)
Misura la capacità di svolgere ragionamenti complessi utilizzando immagini, diagrammi e conoscenze specialistiche.
Esempio di prompt:
“Quale forza agisce sull’oggetto rappresentato in questo diagramma?”
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-25B
Perché Velvet2-3B Vision?
Comprensione di Documenti Complessi
Analizza le informazioni distribuite tra testi, tabelle, grafici e altri elementi visivi.
Comprensione Visiva Multilingue
Elabora didascalie di immagini e testi di documenti in più lingue e risponde a domande sui contenuti visivi.
Input Visivi Multipli
Collega, in un’unica interazione, le informazioni distribuite tra più immagini o pagine di documenti.