

Velvet2-3B Vision
29 de outubro de 2026
Um modelo de visão e linguagem compacto e multilíngue, projetado para compreender imagens e texto em conjunto, possibilitando raciocínio multimodal, compreensão visual e análise de documentos.
A Essência do Velvet2-3B Vision
Baseado no Velvet2-3B, o modelo amplia suas capacidades para tarefas visuais, como compreensão de imagens, análise de documentos, resposta a perguntas sobre conteúdos visuais e extração de informações.
Idiomas
Italiano, inglês, alemão, espanhol, francês e português.
Arquitetura
Arquitetura multimodal que combina o modelo de linguagem Velvet2-3B, um codificador visual SigLIP2 e um projetor dedicado que conecta as representações visuais e linguísticas.
Training Dataset
Treinamento multimodal baseado em datasets de pares imagem-texto e de instruções em seis idiomas, cuidadosamente selecionados para equilibrar a representação linguística e reduzir a predominância do inglês.
IA Responsável
Medidas de segurança integradas à curadoria de dados, ao treinamento e ao pós-treinamento, incluindo filtragem de dados, controles de qualidade, alinhamento e avaliação de segurança, apoiadas por processos contínuos de governança e supervisão interna.
Parâmetros
Modelo de linguagem: 3B. Codificador visual: 433M. Projetor MLP: 14,69M. Adaptadores LoRA: 249M.
Context Window
32K Tokens.
Vocabulário
127K Tokens.
Data Freshness
Data-limite dos dados de pré-treinamento: dezembro de 2025 – janeiro de 2026.
Especialização
Duas etapas: 905K amostras de imagem-texto por época para o alinhamento multimodal, seguidas por 1,25M de amostras de instruções multimodais por época para o ajuste por instruções.
Licença
Open-weight com licença Apache 2.0.
Capacidades
Geração de legendas para imagens
Visual Question Answering (VQA)
Compreensão de documentos
Raciocínio aprimorado por OCR
Information Extraction
Visual Reasoning
Compreensão de gráficos, diagramas e tabelas
Contagem de objetos
Compreensão espacial
Processamento de entradas com múltiplas imagens
Performance Evaluation
Velvet2-3B-Vision foi avaliado em uma ampla variedade de benchmarks que abrangem image captioning, visual question answering, compreensão de documentos, OCR e raciocínio multimodal.
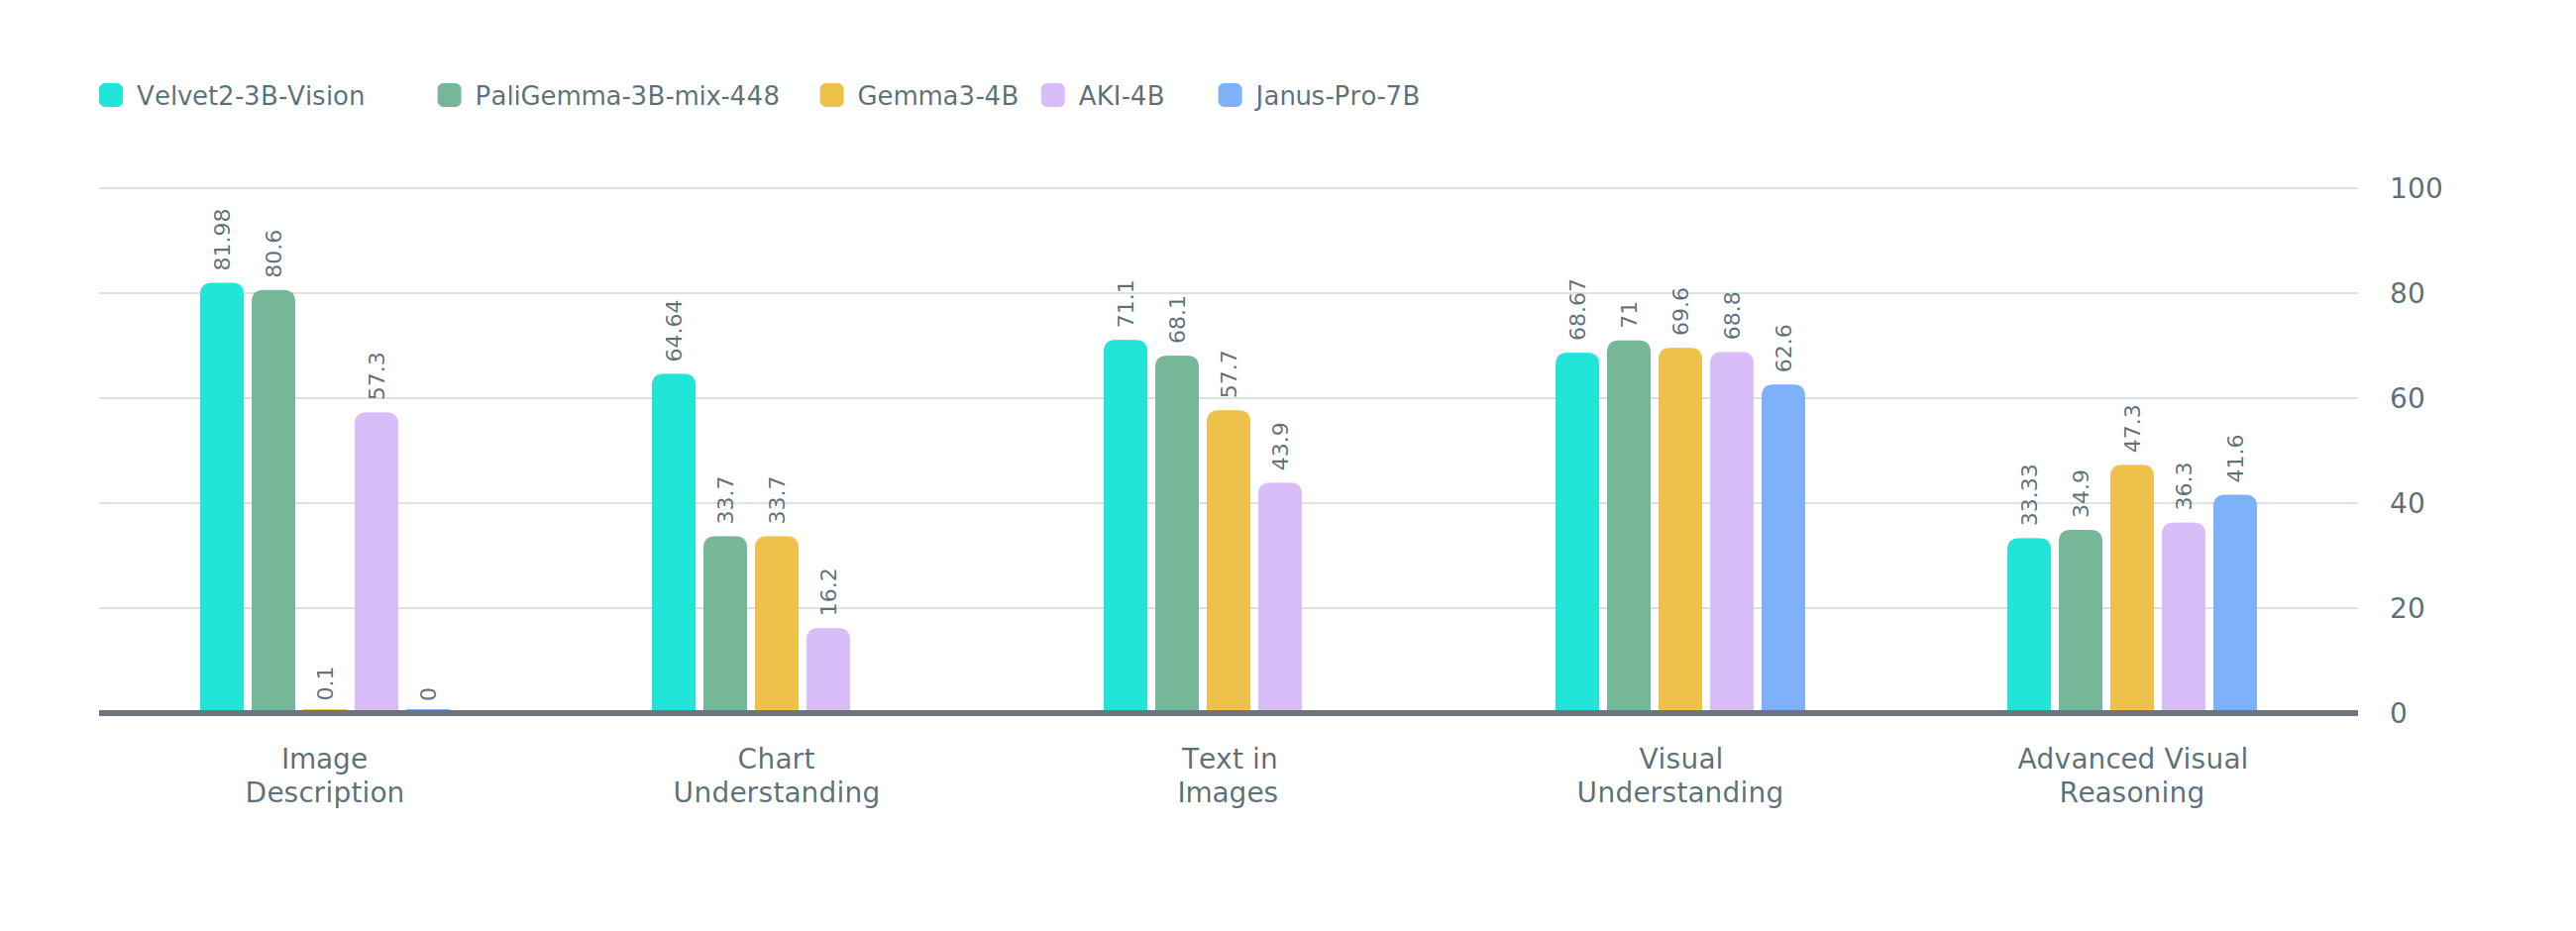
Métricas
Descrição de imagens (COCO CIDEr)
Mede a capacidade do modelo de descrever uma imagem.
Exemplo de prompt:
“Descreva esta imagem em detalhes.”
Compreensão de gráficos (ChartQA)
Mede a capacidade do modelo de compreender gráficos e os dados que eles contêm.
Exemplo de prompt:
“Qual ano apresenta o valor mais alto neste gráfico?”
Texto em imagens (TextVQA)
Mede a compreensão do texto presente nas imagens.
Exemplo de prompt:
“O que está escrito na placa desta imagem?”
Compreensão de documentos (DocVQA)
Mede a capacidade do modelo de encontrar informações em documentos visuais.
Exemplo de prompt:
“Qual é o valor total indicado nesta fatura?”
Compreensão visual (MMBench)
Mede a capacidade geral de compreensão e raciocínio sobre imagens e perguntas.
Exemplo de prompt:
“Qual objeto poderia ser usado para cortar o papel?”
Raciocínio visual avançado (MMMU)
Mede a capacidade de realizar raciocínios complexos utilizando imagens, diagramas e conhecimentos especializados.
Exemplo de prompt:
“Qual força atua sobre o objeto representado neste diagrama?”
Italian language
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 58.6 |
| Commonsense | Hellaswag (0-shot) | 72.7 |
| WinoGrande ITA-bench (0-shot) | 73.2 | |
| PIQA ITA-bench (0-shot) | 71.7 | |
| SciQ ITA-bench (0-shot) with p. | 91.9 | |
| Reasoning | ARC-Challenge (0-shot) | 55.2 |
EU languages
| Category | Benchmark | Velvet-14B |
|---|---|---|
| General | MMLU (5-shot) | 56.4 |
| Instruction Following | IFEval (0-shot) - en | 65.4 |
| Commonsense | Hellaswag (10-shot) | 72.8 |
| WinoGrande (0-shot) - en | 72.5 | |
| Reasoning | ARC-Challenge (25-shot) | 57.3 |
| MUSR (0-shot) - en | 12.3 | |
| Function Calling | BFCL (AST summary) - en | 67.5 |
Discover Velvet AI Models
Velvet Speech-2B
Velvet-2B-1.5
Velvet-2B
Velvet-14B
Velvet-25B
Velvet2-3B speech
Por Que Escolher o Velvet2-3B Vision?
Compreensão de Documentos Complexos
Analisa informações distribuídas entre textos, tabelas, gráficos e outros elementos visuais.
Compreensão Visual Multilíngue
Processa legendas de imagens e textos de documentos em vários idiomas e responde a perguntas sobre conteúdos visuais.
Múltiplas Entradas Visuais
Conecta, em uma única interação, informações distribuídas entre várias imagens ou páginas de documentos.